滾動回測(Walk-Forward,也叫前進測試)是一種檢查策略的方法:把歷史切成很多段,每次只用前面一段挑參數,再拿緊接著的下一段驗收,然後整個窗口往前移一格、重來一次。最後只看所有驗收段拼起來的成績。它模擬的是「你當年真的照這套流程做,會拿到什麼」,所以比在整段歷史上調出最好的參數更接近實際能拿到的結果。
下面直接回答這幾題
滾動回測是什麼?
想像你在準備考試,拿去年的考古題練到滿分,不代表今年會考好,因為你可能只是把那幾題的答案背起來了,換一份題目就露餡。比較可靠的做法是:用前幾年的題目練習,拿下一年的題目當模擬考,而且模擬考只能考一次。滾動回測就是把這件事重複很多年。
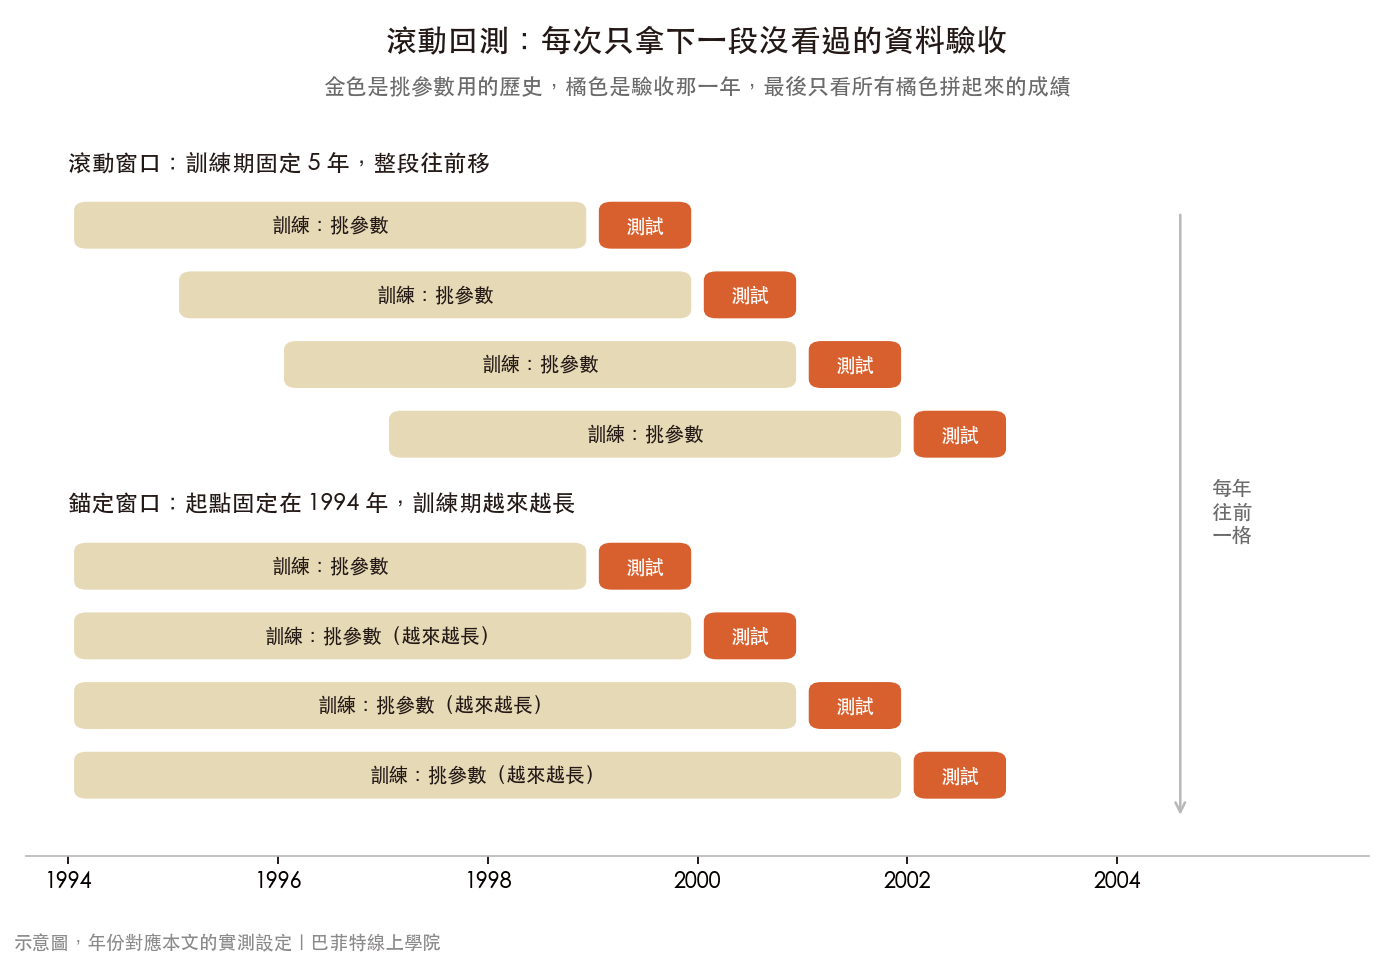
放到投資上,「練習」就是挑參數。例如一套均線策略要決定用幾日線,你在 1994 到 1998 年的資料上試遍各種組合、挑出最好的一組,然後只拿 1999 年來驗收。驗收完,窗口往前移一年,用 1995 到 1999 年重挑、拿 2000 年驗收。一路做到最近一年,把每一年的驗收成績接起來,就是滾動回測的結果。
這個方法的名稱來自英文 Walk-Forward Analysis,中文有人翻成「前進測試」「步進分析」「滾動視窗回測」,講的是同一件事。
切一次樣本外為什麼不夠?
最基本的防過度擬合做法,是把資料切成兩段:前段調參數(樣本內),後段驗收(樣本外)。我們在回測四個陷阱那篇就這樣做過,前段排名第一的均線參數,到了後段掉到第 35 名。
切一刀有兩個問題。第一,驗收只有一次,結果好壞很大一部分取決於後段剛好碰到什麼行情,碰到大多頭就什麼都好看,碰到盤整就什麼都難看。第二,實際操作的人不會十幾年都用同一組參數,通常每隔一段時間就會拿新資料重新檢查、重新調整,切一刀的回測沒有模擬到這個動作。
滾動回測把「調參數、驗收」這個循環做了很多次。驗收次數從一次變成二、三十次,而且模擬了定期重新調整的習慣。它回答的問題也跟著變了:它評的是你挑參數的那套流程,不是某一組參數。
滾動回測怎麼做?
- 先定好規則和候選參數。例如「快線站上慢線就持有,否則抱現金」,快線、慢線各列幾個候選值。這一步在看任何結果之前就要定,之後不准再加。
- 定訓練期與測試期長度。例如每次用過去 5 年挑參數,挑完用接下來 1 年驗收。
- 在訓練期挑出最好的一組。「最好」的標準也要事先定,例如夏普比率最高。
- 把這組參數拿到測試期跑一次,記下成績。然後整個窗口往前移一個測試期長度,回到上一步,直到資料用完。
最後把所有測試期的報酬接起來,算年化報酬、最大跌幅、夏普,這才是你拿來判斷策略的數字。每一輪訓練期裡那個「最佳成績」只是過程,不能拿來當結果。
滾動窗口和錨定窗口怎麼選?
窗口往前移的方式有兩種,結果會不一樣:
| 做法 | 訓練期怎麼變 | 好處 | 代價 |
|---|---|---|---|
| 滾動窗口(Rolling) | 長度固定,起點和終點一起往前移 | 只看最近幾年,市場變了比較快跟上 | 每次用的資料少,挑出來的參數容易跳來跳去 |
| 錨定窗口(Anchored) | 起點固定在最早那一年,終點往前移,越來越長 | 資料越用越多,參數比較穩 | 很久以前的行情一直佔很大比重,反應慢 |
哪一種比較好,沒有標準答案。我們在下面的實測裡兩種都跑了,結果剛好說明:窗口長度本身也是一個你挑出來的參數。
BOS 回測:每年重挑一次均線參數
設定是這樣:標的是追蹤美股 S&P 500 的 SPY,用含息報酬。規則是快線站上慢線就持有 SPY,否則把錢放在 3 個月期美國國庫券。快線從 5、10、20、30、40、50 日裡選,慢線從 50、75、100、150、200、250 日裡選,快線要比慢線短,共 35 組。每年用過去 5 年挑夏普最高的一組,拿下一年驗收,從 1999 年做到 2025 年,共 27 個驗收年。訊號一律收盤算、隔天才進出,每次進出扣 0.05% 成本。
| 做法 | 年化報酬 | 夏普比率 | 最大跌幅 |
|---|---|---|---|
| 買進持有 SPY | 8.4% | 0.41 | -55.2% |
| 事後最佳(整段期間最好的 10/200 日線) | 8.7% | 0.58 | -20.3% |
| 滾動回測(每年用過去 5 年重挑) | 8.5% | 0.57 | -21.5% |
| 錨定回測(每年用 1994 年起的全部資料重挑) | 7.7% | 0.48 | -33.3% |
| 35 組參數的中位數 | 6.9% | 0.44 | - |
期間 1999 年 1 月至 2025 年 12 月。夏普比率=扣掉國庫券報酬之後的年化超額報酬÷年化波動。歷史回測、假設性測算,不是實際帳戶績效,過去績效不代表未來。
「事後最佳」那一列是你永遠拿不到的成績:10/200 日線這個答案要到 2025 年底回頭看才知道。滾動回測那一列才是 1998 年底的人照這套流程一路做下來、每年年底拿新資料重挑一次參數,實際做得到的成績。在這組資料上兩者剛好很接近,但滾動回測背後用過 12 組不同的參數,跟「一組參數用到底」是兩回事。另外,27 年的夏普本身還有正負 0.2 左右的誤差,表上幾列的夏普差距大多落在這個範圍內,不能拿來排名。
表上的最大跌幅也看得出均線策略的本性。2008 年金融海嘯那種大跌,均線會讓你提早下車,跌幅比買進持有淺很多。代價是錯過反彈和盤整時的來回挨打,這個在200 日均線實測有完整拆解。
挑的時候是第一名,隔年只排在中段
每一年挑參數的時候,被挑中的那組在訓練期都是 35 組裡的第一名。到了下一年,它在同樣 35 組裡排第幾?中位數是第 14 名,而正中間是第 18 名。
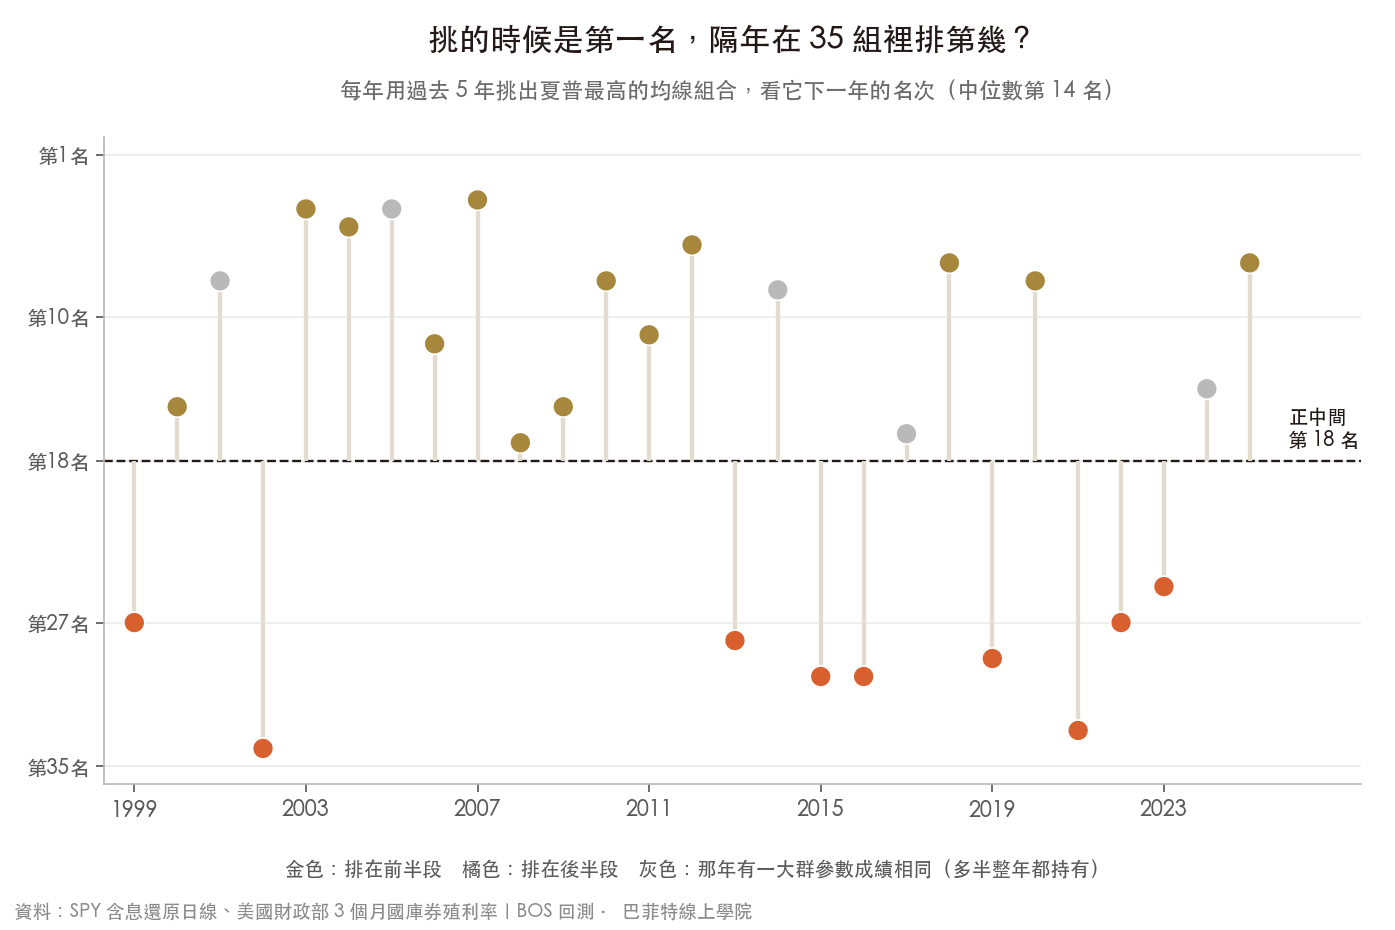
圖上灰色的 5 年,是一大群參數成績完全相同的年份:那幾年大部分均線組合整年都沒有進出,多半是整年持有 SPY(2001 年則是整年空手),成績一模一樣,名次只能取並列的平均。把這幾年拿掉,剩下 22 年的中位數是第 15 名,還是在中段。
用夏普來看也是同一件事。挑的時候,被挑中的那組平均夏普 0.83,35 組的平均只有 0.49,高出一大截。到了下一年,它平均 0.54,全體平均 0.47,領先幅度大多不見了。這個平均會被 2002、2022 這種極端年份拉動,而且逐年看有 12 年的下一年夏普反而比挑的時候高,所以「掉多少」每段期間都不一樣,比較能確定的是領先會縮水。
為什麼領先會縮水?因為「挑最高的」這個動作本身就會挑到運氣最好的那組。35 組參數在同一段歷史裡比賽,冠軍的成績一部分是實力,一部分是剛好碰上那段行情,到了下一年實力還在,運氣卻不會跟著過來。回測裡看到的最佳成績,預設就要打折。
27 年裡用過 12 組參數
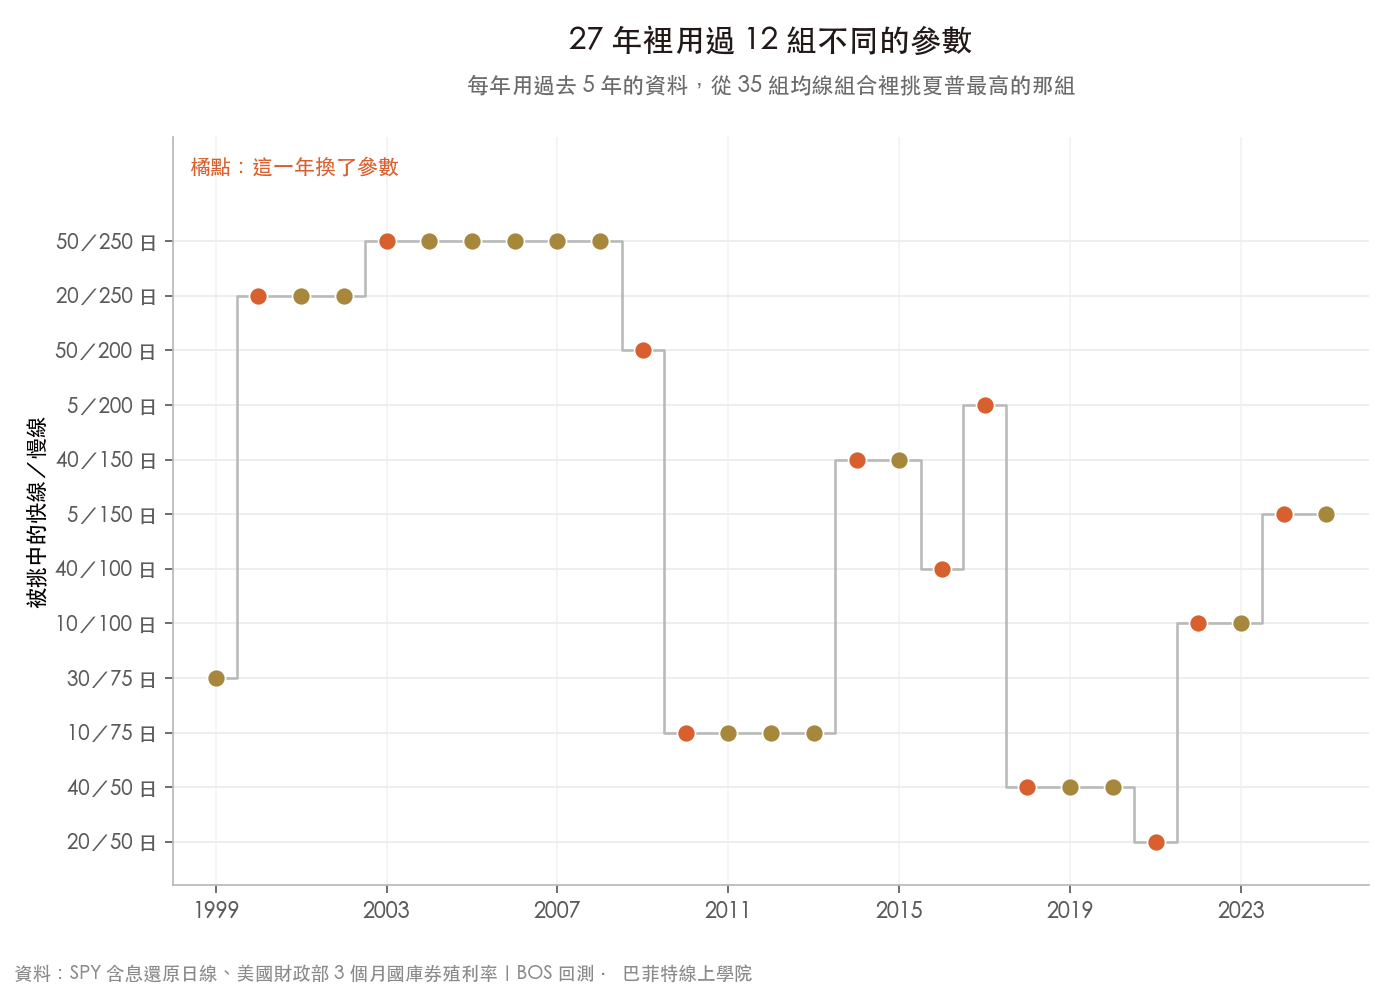
2003 到 2008 年連續六年都挑到 50/250 日,看起來很穩定。2009 年之後就開始跳:10/75、40/150、40/100、5/200、40/50⋯⋯27 年裡換了 11 次。如果「最佳參數」真的抓到了市場的某種規律,它不應該每隔兩三年就換一組,參數一直換,比較可能的解釋是每一段歷史的冠軍有很大一部分是那幾年的行情造成的,再加上 40/150、40/100、40/50 這類相鄰的參數,成績本來就很接近,冠軍很容易換人。
單看一年的成績,幾乎都是雜訊
逐年來看,被挑中的參數在測試年的夏普,最差是 -2.23(2022 年),最好是 2.82(2017 年)。只用一年的資料算夏普,誤差大約正負 1,比這裡的平均值 0.54 還大。所以「這套方法在幾年裡贏了幾年」這種數法,在年數少的時候說明不了什麼。要判斷,看的是 27 年拼起來的總成績,而它的不確定性也還有正負 0.2 左右。
跟隨便挑參數比,有比較好嗎?
滾動回測的成績看起來不錯,但它到底有沒有挑出東西?要檢查這件事,可以做一個對照:每一年不看任何資料,從 35 組裡隨便抽一組來用,拼成一條成績,這樣重複 2,000 次。這 2,000 條就是「完全靠運氣」能做到的範圍。
| 挑參數的方式 | 夏普比率 | 贏過隨便挑的比例 |
|---|---|---|
| 每年用過去 3 年重挑 | 0.56 | 94% |
| 每年用過去 5 年重挑 | 0.57 | 95% |
| 每年用過去 10 年重挑 | 0.47 | 67% |
| 錨定(1994 年起全部資料) | 0.48 | 71% |
| 隨便挑,2,000 次的中間 90% | 0.31~0.57 | - |
訓練期不足 10 年的早期年份,用 1994 年起能取得的全部資料。歷史回測、假設性測算,過去績效不代表未來。
用過去 3 年或 5 年挑,贏過大約九成五的隨便挑,剛好壓在運氣範圍的上緣,但這是試了四種窗口之後最好看的兩種,本身就有挑過的成分。改成 10 年或錨定,就只贏過七成上下,跟隨便挑差不多。同一套策略、同一段資料,只因為窗口長度不同,結論就從「好像有點東西」變成「跟亂猜差不多」。如果你試了好幾種窗口長度、最後只報告最好看的一種,等於又在窗口長度上過度擬合了一次。
拿去跟買進持有比,也會隨期間翻過來。1999 到 2009 年,滾動回測年化 7.2%,買進持有只有 0.8%,因為這段期間有兩次大空頭。2010 到 2025 年以多頭為主,滾動回測 9.3%,買進持有 14.0%。逐年比,27 年裡滾動回測贏 6 年、輸 14 年,另外 7 年整年都持有 SPY、成績一樣。這類結果只說明均線策略的機制:躲大跌、但會錯過漲勢,不能拿來排名哪個比較好。
自己做滾動回測的五個提醒
- 候選參數和挑選標準先寫下來。如果看過結果才回頭加候選值、換挑選標準,就算每一步都照滾動回測的流程走,測試期的資料也已經被你偷看過了。
- 窗口長度只選一種,選之前講得出理由。例如「這套策略一年交易幾次,5 年才有足夠的交易次數」。多種都跑的話,全部一起報告。
- 只看拼起來的測試期成績。訓練期的最佳成績會系統性偏高,在我們的實測裡,挑的時候的第一名,下一年的名次中位數只排在中段。
- 每一輪都要防未來函數。訊號收盤算、隔天才交易,挑參數用的資料不能碰到測試期。
- 加一個「隨便挑」的對照。每期隨機抽參數重跑幾千次,看你的成績有沒有明顯跑出那個範圍。沒有的話,挑參數這個動作就沒有加分。
滾動回測通過,也只代表這套流程在過去沒有明顯失靈。它防的是過度擬合裡最常見的那種「把參數調到剛好貼合歷史」,防不了存活者偏差、成本低估,也防不了市場結構本身改變。
常見問題
滾動回測是什麼?
滾動回測(Walk-Forward Analysis)是把歷史資料切成很多段,每次用前一段挑參數、用緊接著的下一段驗收,再把窗口往前移、重複做,最後只看所有驗收段拼起來的成績。它模擬實際操作時「定期用新資料重新調整」的過程,比在整段歷史上挑最佳參數更接近實際做得到的結果。
滾動回測和樣本外測試有什麼不同?
一般的樣本外測試只切一刀:前段調參數、後段驗收一次。滾動回測把這個循環做很多次,驗收次數從一次變成二、三十次,結果比較不會被某一段行情左右。它評的是挑參數的整套流程,不是某一組固定參數。
滾動窗口和錨定窗口怎麼選?
滾動窗口的訓練期長度固定、整段往前移,反應快但參數容易跳。錨定窗口的起點固定、訓練期越來越長,參數穩但反應慢。沒有標準答案,重點是事先只選一種並講得出理由。BOS 回測裡,同一套均線策略用 5 年窗口和用 10 年窗口,結論就差很多。
訓練期要多長?
要長到裡面有足夠多的交易次數,又不能長到把早就不適用的行情一直算進去。交易少的慢策略通常要好幾年,交易多的短線策略可以短一點。不要多種長度都試、最後只挑最好看的一種,那會在窗口長度上再過度擬合一次。
為什麼回測挑出的最佳參數,實際用起來會變差?
因為「挑最高的」本身就會挑到那段期間運氣最好的組合,它的成績一部分是剛好碰上那段行情。BOS 回測 SPY 的 35 組均線參數:每年用過去 5 年挑出的第一名,到了下一年在 35 組裡的名次中位數是第 14 名,接近正中間。
滾動回測通過就代表策略有效嗎?
不代表。它只說明挑參數的流程在過去沒有明顯失靈,還要再跟「每期隨便挑參數」的對照比,看成績有沒有明顯超出運氣範圍。存活者偏差、交易成本低估、市場結構改變,滾動回測都防不了。

投資與教學資歷都超過二十年。教學橫跨三個階段:從兒童理財教育起步,到成人的價值投資,再到近年的量化交易。曾創立三間公司,並以價值投資建立起財務上的獨立與自信,也擔任過台積電的理財培訓師,是價值投資的國際級講師。他始終相信,理財是為了把生活過得更好,而看懂財報、獨立思考,遠比追逐明牌或現成的答案更重要。
延伸閱讀
 回測賺翻了實盤卻不行?
 未來函數是什麼?
本文為投資教育內容,不構成投資建議。文中數字皆為歷史回測與假設性測算,不是實際帳戶績效,過去績效不代表未來。